 TR
 Türk Telekom Proxy
 Turkcell Proxy
 Vodafone Proxy
 Metin2
 Knight Online
 Silkroad Online
 Black Desert
 World of Warcraft
 Minecraft
 Valorant
 League of Legends
 Counter-Strike 2
 PUBG
 Fortnite
 Roblox
 GTA Online
 Diablo
 Path of Exile
 RuneScape
 Growtopia
 Aion
 Steam
 Instagram
 Facebook
 TikTok
 YouTube
 X (Twitter)
 WhatsApp
 Telegram
 Discord
 Reddit
 Snapchat
 Pinterest
 LinkedIn
 Twitch
 Spotify
 Threads
 Tumblr
 VK
 WeChat
 LINE
 Signal
 Messenger
 Quora
 Almanya
 Fransa
 İngiltere
 Hollanda
 İtalya
 İspanya
 Polonya
 ABD
10GB Residential Rotating Proxy
650 ₺/ ay
Proxy Satın Al
Plan no. 141
Veri kazıma, doğru yapıldığında araştırma ve iş zekâsı için güçlü bir araçtır. Yanlış yapıldığında ise hedef siteyi yorar, hukuki risk doğurur ve sonuçsuz kalır. Proxy bu denklemin yalnız bir parçasıdır.
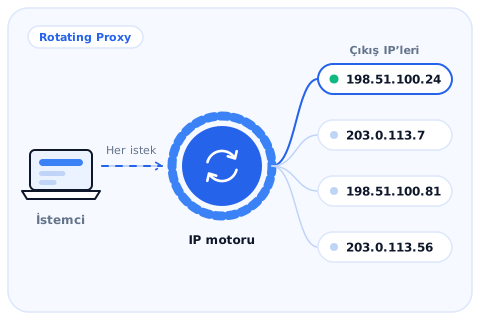
Proxy'nin scraping'deki asıl işlevi, istekleri tek bir kaynaktan değil, birden fazla çıkış noktasından göndermektir. Bu, sunucunuzun IP'sine düşen yükü dağıtır, bölgeye göre değişen içeriği görmenizi sağlar ve kurum ağınızı toplama trafiğinden ayırır. Ancak proxy, bir sitenin açıkça koyduğu sınırları aşmanın meşru bir yolu değildir.
Pek çok scraping projesi proxy eksikliğinden değil, kötü tasarımdan başarısız olur: gereksiz yere her sayfayı yeniden indirmek, statik dosyaları da çekmek, sayfa başına onlarca istek atmak veya hata aldığında saniyesinde tekrar denemek. Önce isteği azaltmak, sonra dağıtmak gerekir.
Kişisel veri konusu Türkiye'de KVKK, Avrupa'da GDPR kapsamında ciddiye alınmalıdır. Herkese açık bir sayfadaki ad, telefon veya e-posta bilgisi de kişisel veridir; bunları toplu biçimde derlemek ve işlemek ayrı bir hukuki değerlendirme gerektirir.
| Kriter | Rotating residential | Statik ISP / datacenter |
|---|---|---|
| Yük dağıtımı | Her istekte farklı çıkış | Sabit çıkışlar; dağıtım havuz büyüklüğüne bağlı |
| Oturumlu akış | Sticky oturumla mümkün | Doğal olarak uygun |
| Faturalama | GB kotalı veya sınırsız (hız kademesi) | Adet bazlı |
| Uygun hedef | Çok sayıda bağımsız sayfa | İzin verilmiş, kayıtlı erişim ve sabit whitelist |
| Hata ayıklama | Değişen IP nedeniyle daha zor | Aynı IP ile tekrarlanabilir |
Datacenter IP'leri bazı sitelerde daha sık doğrulama ile karşılaşabilir; seçim hedef siteye göre yapılmalıdır.
Bu örnek robots.txt'yi proxy üzerinden okur, izin verilmeyen yolları atlar, belirtilmişse crawl-delay süresine uyar ve kendini açık bir kullanıcı ajanıyla tanıtır.
import time
from urllib.parse import urljoin
from urllib.robotparser import RobotFileParser

import requests

PROXY = "http://kullanici:sifre@proxy.example.com:8000"
AJAN = "OrnekFiyatBotu/1.0 (+https://ornek-sirketiniz.com/bot)"
SITE = "https://www.example.com"

oturum = requests.Session()
oturum.proxies = {"http": PROXY, "https": PROXY}
oturum.headers["User-Agent"] = AJAN

# robots.txt dosyasını da proxy üzerinden okuyup ayrıştırıyoruz
robots = RobotFileParser()
robots.parse(oturum.get(urljoin(SITE, "/robots.txt"), timeout=15).text.splitlines())
bekleme = robots.crawl_delay(AJAN) or 3  # site belirtmediyse 3 sn

for yol in ["/kategori/kulaklik", "/kategori/klavye"]:
    adres = urljoin(SITE, yol)
    if not robots.can_fetch(AJAN, adres):
        print("robots.txt izin vermiyor, atlanıyor:", adres)
        continue
    yanit = oturum.get(adres, timeout=20)
    print(adres, yanit.status_code, len(yanit.text))
    time.sleep(bekleme)
Kullanıcı ajanında iletişim adresi olarak kendi sitenizi gösterin. www.example.com yerine izin aldığınız hedefi yazın.
Hacme göre GB kotalı residential paketler; sürekli ve yüksek hacimli iş yükleri için hız kademeli sınırsız residential; izinli ve sabit IP gerektiren işler için datacenter.
Sipariş, müşteri panelinde (Türkçe arayüz) tamamlanır. Fiyatlara vergiler dahil değildir; tutarlar 3 Kasım 2026 itibarıyla panelle eşleştirilmiştir. Yardım için WhatsApp.
Hedef sitenin kullanım koşullarına, robots.txt yönergelerine, telif hakkına ve KVKK başta olmak üzere kişisel veri mevzuatına uymak kullanıcının sorumluluğundadır. Kişisel veri derleme, kimlik bilgisi toplama ve hizmet aksatma amaçlı kullanım için hizmet vermiyoruz.
robots.txt bir teknik yönergedir ve tek başına her ülkede hukuki bağlayıcılık taşımayabilir. Ancak sitenin isteğini açıkça ortaya koyar; ona uymak hem etik hem de olası uyuşmazlıklarda savunulabilir bir tutumdur.
Evrensel bir sayı yoktur. Site crawl-delay belirtmişse ona uyun; belirtmemişse birkaç saniyelik aralıkla başlayıp hedef sunucunun yanıt sürelerini izleyin. Yanıtlar yavaşlıyorsa hızı düşürün.
Hayır. Az sayıda sayfayı düzenli okuyan bir proje tek bir statik IP ile sorunsuz çalışabilir. Rotating yapı, çok sayıda bağımsız sayfayı geniş bir zamana yaymanız gerektiğinde anlam kazanır.
Aylık veri tüketiminizi ölçün. Tüketim yüksek ve sürekliyse plan adındaki hız kademesine göre faturalanan sınırsız paketler daha öngörülebilir olabilir; düzensiz veya düşük hacimde GB kotası daha ekonomiktir.
Captcha, sitenin otomatik erişimi sınırlamak istediğinin açık bir işaretidir. Onu otomatik olarak aşmaya çalışmak yerine istek hızınızı ve yönteminizi gözden geçirin ya da site sahibinden izin veya API erişimi isteyin.
Bu, verinin niteliğine ve hedef sitenin haklarına bağlıdır. Fiyat gibi olgusal veriler ile özgün metin ve görseller farklı değerlendirilir. Yayımlamadan önce hukuki görüş almanızı öneririz.
HTTP tabanlı scraping'de HTTP proxy çoğunlukla yeterlidir. SOCKS5, HTTP dışı protokollerde veya DNS çözümlemesinin proxy tarafında yapılmasını istediğiniz durumlarda tercih edilir.
Paketleri karşılaştırın, ihtiyacınıza uygun olanı seçin. Kararsız kaldığınız noktada WhatsApp üzerinden sorabilirsiniz.